
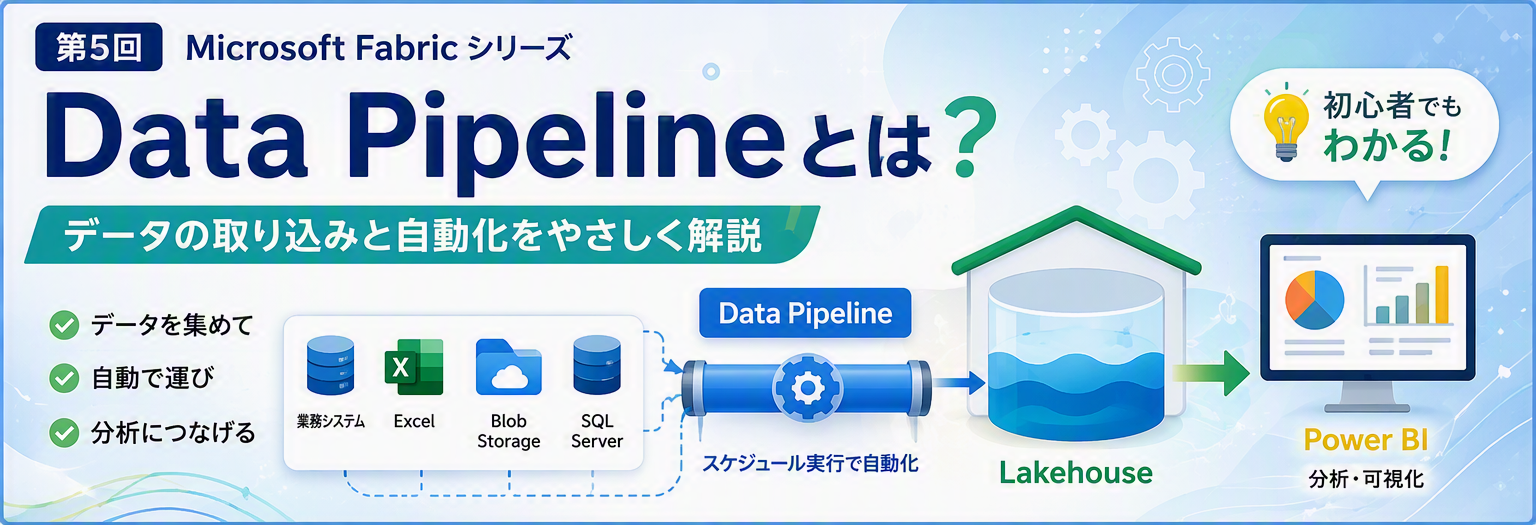
Data Pipelineとは?Microsoft Fabricでデータ連携を自動化する仕組みをやさしく解説
前回は、Microsoft Fabricの中核機能である「Lakehouse」について解説しました。
今回は、データを集めて運ぶ役割を担う
Data Pipeline(データパイプライン)
について紹介します。
データ分析では、
- データを集める
- 分析用に保存する
- 加工する
- 可視化する
という流れがあります。
Data Pipelineは、その最初のステップである
「データを集める」
を自動化する仕組みです。
Data Pipelineとは?
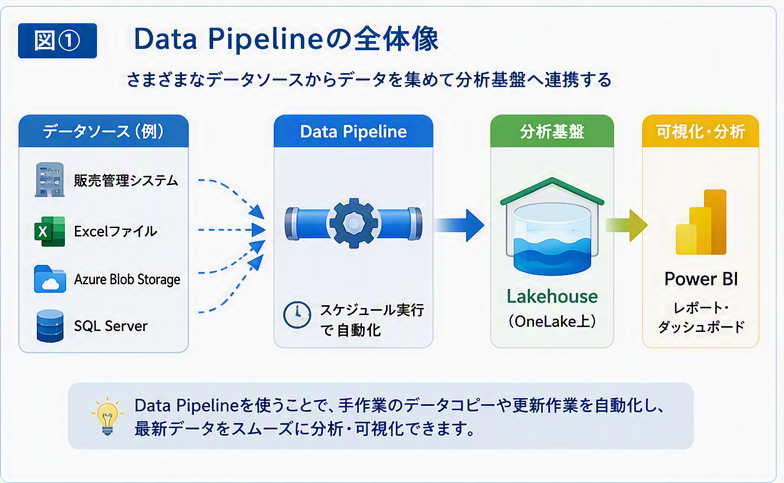
Data Pipelineを一言で表すと、
「データを自動で運ぶ仕組み」
です。
例えば、
- Azure Blob Storage
- SQL Server
- Excelファイル
- 業務システム
などに保存されているデータを、
LakehouseやWarehouseへ自動で取り込むことができます。
人が毎日手作業でデータをコピーする必要がなくなります。
なぜData Pipelineが必要なのか
分析用のデータは、さまざまな場所に保存されています。
- 販売管理システム
- 会計システム
- Excelファイル
- クラウドストレージ
しかし、そのままでは分析しづらいため、
データを分析基盤へ集約する必要があります。
毎日手作業で行うと、
- 時間がかかる
- ミスが発生する
- 担当者依存になる
といった問題が発生します。
Data Pipelineを利用すると、
決められた処理を自動で実行できるようになります。
Data Pipelineでできること
データコピー
もっとも利用される機能です。
例えば、
- Blob Storage → Lakehouse
- SQL Server → Lakehouse
- Excel → Warehouse
といったコピー処理を簡単に設定できます。
スケジュール実行
毎日や毎時間など、
決められたタイミングで自動実行できます。
例えば、
- 毎日午前6時に実行
- 毎月1日に実行
- 1時間ごとに実行
といった設定が可能です。
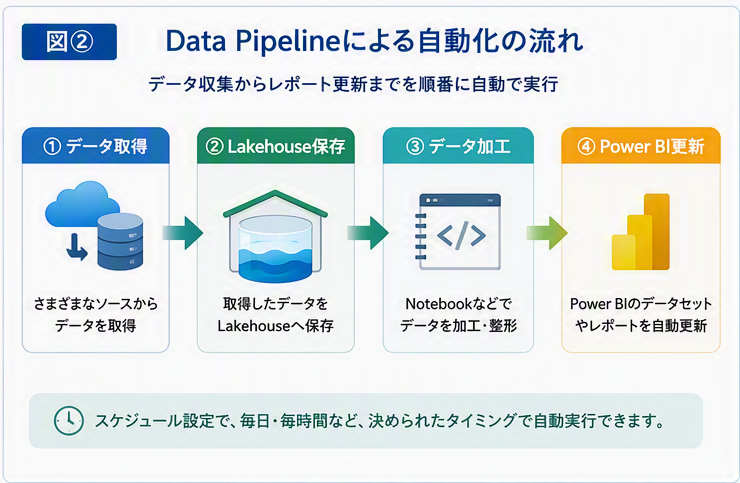
複数処理の実行
複数の処理を順番に実行できます。
例えば、
- データを取得
- Lakehouseへ保存
- Notebookで加工
- Power BIを更新
という流れを自動化できます。
Data Pipelineの利用イメージ
営業データを分析するケースを考えてみましょう。
毎日、販売管理システムに売上データが登録されます。
Data Pipelineを利用すると、
- 売上データを取得
- Lakehouseへ保存
- 分析用テーブルを更新
- Power BIレポートを更新
という流れを自動化できます。
朝出社した時には、
最新データのレポートを確認できる状態になります。
Data PipelineとAzure Data Factoryの関係
Azureを利用したことがある方は、
Azure Data Factory(ADF)を知っているかもしれません。
Data Pipelineは、
ADFで利用されている仕組みをベースにしています。
そのため、
ADF利用経験者であれば比較的スムーズに利用できます。
初心者の方は、
「Fabricの中で使えるデータ連携機能」
と理解しておけば十分です。
初心者が最初に覚えるべきこと
最初は複雑な設定を覚える必要はありません。
まずは次の考え方だけ押さえましょう。
- データを集める
- Lakehouseに保存する
- Power BIで分析する
その最初の部分を担当するのがData Pipelineです。
まとめ
Data Pipelineを一言で表すと、
「データを自動で運ぶ仕組み」
です。
Microsoft Fabricでは、
Data Pipelineを利用することで、データ収集から分析までの流れを自動化できます。
データ分析を継続的に行うためには欠かせない重要な機能です。
